Ultralytics YOLO-Depth
1枚のRGB画像から、視認できるすべての表面までの距離を予測します。YOLO26 depthモデルは、専用の深度センサー、ステレオカメラ、lidarなしで、メートル単位の3D空間認識を実現します。
YOLO26深度推定モデル
YOLO26-depthモデルは、1枚のRGB画像からメートル単位の高密度深度マップを予測します。5つのモデルサイズが用意され、エッジデプロイから精度が重視される空間分析まで対応します。公開済みの重みは、屋内外の約219万枚の画像で事前学習されており、NYU Depth V2のEigenテスト分割で評価されています。
pip install ultralyticsfrom ultralytics import YOLO
# Load a YOLO26 depth model
model = YOLO("yolo26n-depth.pt")
# Predict metric depth at the model training resolution
results = model("image.jpg", imgsz=768)
depth_map = results[0].depth.data.cpu().numpy()| モデル | サイズ(px) | delta1 | abs_rel | RMSE(m) | パラメーター数(M) | FLOPs(B) |
|---|---|---|---|---|---|---|
| YOLO26n-depth | 768 | 0.882 | 0.109 | 0.414 | 6.4 | 46.9 |
| YOLO26s-depth | 768 | 0.896 | 0.104 | 0.399 | 13.2 | 67.9 |
| YOLO26m-depth | 768 | 0.921 | 0.089 | 0.364 | 23.3 | 130.7 |
| YOLO26l-depth | 768 | 0.930 | 0.083 | 0.351 | 27.7 | 157.2 |
| YOLO26x-depth | 768 | 0.933 | 0.080 | 0.344 | 57.0 | 302.0 |
NYU Depth V2のEigenテスト分割におけるYOLO26深度推定のベンチマーク。マルチスケールと水平反転のTTAに加え、対数最小二乗アラインメントを使用しています。パラメーター数とFLOPsは768 × 768で測定しています。
世界をリードする組織から信頼されています





当社のモデルがもたらす影響
最先端のビジョンAIモデルで、さまざまな業界のプロセスを効率化します。Ultralyticsが、スピード、精度、使いやすさを実現します。
Ultralytics YOLOモデルの進化
実用的なYOLOv5のワークフローからエッジ対応のYOLO26推論まで、Ultralytics YOLOの進化をご覧ください。
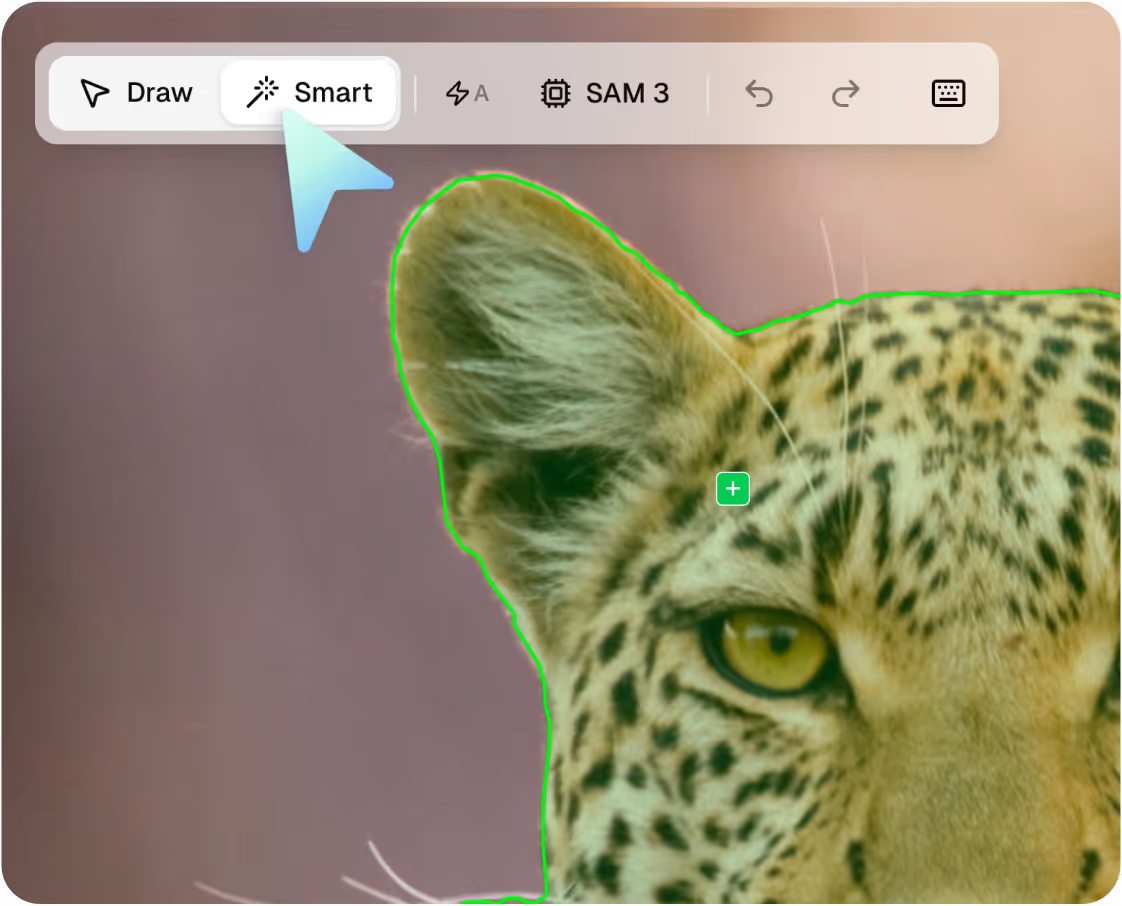
スマートアノテーションでラベル付けを最大10倍高速化
Ultralytics Platformは、高品質なデータセットをより速く構築するための画像アノテーションツールを提供します。スマートアノテーションから精密な手動編集まで、品質を損なうことなく画像のラベル付けにかかる時間を短縮できるよう設計されています。
- SAMを活用したスマートアノテーション:ワンクリックでマスクとバウンディングボックスを作成できます。
- あらゆるAIタスクに対応:検出、インスタンスセグメンテーション、セマンティックセグメンテーション、分類、姿勢推定、OBB。
- 幅広いフォーマットに対応:YOLO、COCOなどから選択できます。
- チームレビューとバージョン管理:あらゆる段階で明確なコラボレーションを実現します。
優れたGPUを低コストでトレーニングに活用
AmpereからBlackwellまで、NVIDIA GPU 26種類を1時間あたり0.24ドルからご利用いただけます。上乗せ料金なし、最低利用額なし、契約義務なし。
業界別ソリューションを見る
さまざまな本番環境で、チームがUltralyticsのコンピュータービジョンをどのように活用しているかをご覧ください。

農業

自動車

ヘルスケア

物流

製造

小売

ロボティクス
農業
自動車
ヘルスケア
物流
製造
小売
ロボティクス
農業
自動車
ヘルスケア
物流
製造
小売
ロボティクス
よくある質問
Ultralytics YOLO-Depthは、単眼深度推定用のYOLO26モデルファミリーです。通常のRGB画像1枚から、メートル単位のピクセルごとの高密度深度マップを予測します。YOLO26n-depthからYOLO26x-depthまで、5つのサイズの公式事前学習済みチェックポイントを利用できます。
深度情報により、2D検出を3D理解へと拡張できます。障害物までの距離、物体の実際の大きさ、シーンの配置を把握できます。標準的なカメラ1台で処理できるため、lidarやステレオカメラシステムに伴うコスト、キャリブレーション、統合の負担を避けられ、ロボティクス、モビリティ、一般的なカメラシステムで空間認識を実用化できます。
各予測は、入力画像に位置合わせされた高密度のfloat深度マップを1つ返します。
result.depth.dataからアクセスできます。値はメートル単位の距離を表し、3D再構築、ナビゲーション、計測、可視化に使用するNumPy配列に変換できます。結果の仕様については、深度予測ガイドをご覧ください。はい。各RGB画像にメートル単位のfloat32深度マップを組み合わせ、標準のUltralytics train modeで事前学習済みのYOLO26-depthチェックポイントをファインチューニングします。公式ガイドでは、公開済みの重みをカスタム深度ドメインに適応させる際に、AdamWと低い学習率を推奨しています。
export modeを使って、YOLO26-depthチェックポイントをONNX、OpenVINO、TensorRT、CoreMLなどの形式に変換できます。その後、エッジ、モバイル、サーバーのハードウェアで、同じUltralyticsの予測ワークフローを使ってエクスポート済みモデルを実行できます。
Ultralytics YOLO-Depthで構築
Ultralytics PlatformでYOLO26深度推定モデルのトレーニング、検証、エクスポート、デプロイができます。